使用 S3KeySensor 讓 Airflow 不用等一輩子檔案
只要能等到檔案生成,我什麼都願意做
Airflow 裡「等外部非同步產生的檔案才能繼續」是很常見的情境
但「多久都願意等」,對負載來說是多麼沉重的一句話
既有問題
目前經手一個系統整合流程,透過 Airflow 排程,主要步驟:
- 接收參數
- 呼叫外部 API,產生一份要交換的文件
- 產生完成後,繼續往下進行後續流程
其中「等檔案產生完成」這個環節,前後在不同專案裡用過兩種做法
第一版
直接呼叫外部 API 等對方把檔案產生完才回應
檔案產生要花一段時間,常常等到 API timeout 就被切斷連線,整個 task 直接失敗
當時的解法是把 timeout 設定拉長,治標不治本
第二版
改成外部服務產生檔案的同時,把檔案生成完成的狀態寫進 Redis
當初的工程師手刻了一個 sensor 等 Redis key 出現才往下走,藉此繞過 timeout 問題
看似解決了 timeout,但實際運行時踩了幾個坑:
- worker 所在的 ECS instance 使用率過低時會被自動回收,上面可能還有 task 在等待
- Redis key 會過期,沒有即時檢查到就會查不到狀態,即使檔案其實已經產生完成
上面兩個問題還會量子糾纏,變成更麻煩的:
ECS instance 被回收之後沒人繼續檢查,key 就這樣默默過期了
直接變成薛丁格的狀態,就算失敗也不一定是真的失敗
目前的應對方式是拉長 scale-in 的 cooldown period 並加大預設 worker 數量
一樣是治標不治本
解決方案
S3KeySensor + deferrable 來拯救大家啦!
在 Airflow 裡「等外部非同步產生的檔案才能繼續」這種情境其實很常見
內建的 S3KeySensor
就是設計來處理這件事的!
可以直接偵測「S3 上某個 key 是否存在」
而且是用 S3 object 作為偵測目標,所以不會有 Redis key 過期的問題
加上 S3KeySensor 是 Airflow 官方 provider 維護的標準實作
經過 Airflow 官方驗證使用 deferrable=True 時不會佔用 worker slot
也不會有 worker 因為 ECS instance 被回收而中斷的問題
支援三種模式:
mode="poke"(預設值):task 會佔用 worker slot 直到條件成立為止mode="reschedule":檢查時會重新排程一個 worker 執行,在檢查中間會釋放 worker slotdeferrable=True(預設是False):把「等待」交給獨立的 triggerer process 處理,不佔用 worker
三者之間是有優先順序的,可以查看 S3KeySensor.execute() 的原始碼
apache/airflow GitHub - providers/amazon/…/sensors/s3.py
def execute(self, context: Context) -> None:
    if not self.deferrable:
        super().execute(context)   # mode="poke"/"reschedule" 只在這裡起作用
    else:
        if not self.poke(context=context):
            self._defer()          # 交給 triggerer 背景等待,不佔用 worker
當 deferrable=True 時只會 poke 一次,沒滿足就直接丟給 triggerer,無論 mode 設什麼都不會生效
而 mode 只有在 deferrable=False 時才有意義
本篇的範例選擇了 deferrable=True 就不需要、也不應該再另外設定 mode
其他相關參數的預設值:
poke_interval:預設 60 秒,每次檢查間隔timeout:預設 604800 秒(7 天),逾時仍等不到就判定失敗
概念驗證
寫了一個簡單的 DAG 驗證整個機制:
import logging
from datetime import UTC, datetime, timedelta

from airflow.providers.amazon.aws.sensors.s3 import S3KeySensor
from airflow.sdk import DAG, Param, Variable, get_current_context, task
from airflow.sdk.definitions.param import ParamsDict
from services.aws.s3_client import S3Client

logger = logging.getLogger(__name__)

default_args = {
    "owner": "Developer",
    "depends_on_past": False,
    "start_date": datetime(2026, 9, 22, tzinfo=UTC),
    "retry_delay": timedelta(minutes=1),
}

with DAG(
    dag_id="s3_key_sensor_test",
    default_args=default_args,
    schedule=None,
    catchup=False,
    max_active_runs=1,
    dag_display_name="S3KeySensor 概念驗證",
    tags=["AWS"],
    doc_md="""\
        ## 測試 `S3KeySensor` 用法

        1. `get_s3_path`:產生要監控的 S3 路徑
        2. `wait_for_key`:等待 `get_s3_path` 產生的 S3 object 出現才會往下走
        3. `fetch_value`:偵測到檔案後用既有的 `S3Client` 讀取內容,回傳長度 (bytes)
        4. `print_value`:接收 `fetch_value` 的回傳值並印出來
    """,
    params=ParamsDict(
        {
            "bucket_name": Param(
                default="",
                type="string",
                title="S3 Bucket",
                description="S3 bucket name",
            ),
            "bucket_key": Param(
                default="",
                type="string",
                title="Bucket Key",
                description="S3 object key",
            ),
        }
    ),
) as dag:

    @task(task_id="get_s3_path", multiple_outputs=True)
    def get_s3_path() -> dict[str, str]:
        """模擬正式流程中路徑是由程式邏輯算出來的,這裡先直接用 Trigger DAG 帶入的 params 代替

        multiple_outputs=True 讓每個 dict key 分別存成獨立的 XCom 鍵值,下游才能用 s3_path["bucket_name"] 這種下標語法取值,否則會拿到 None

        Returns:
            dict[str, str]: 各自對應一個 XCom key
        """
        params = get_current_context().get("params", {})
        return {
            "bucket_name": params["bucket_name"],
            "bucket_key": params["bucket_key"],
        }

    s3_path = get_s3_path()

    wait_for_object = S3KeySensor(
        task_id="wait_for_object",
        bucket_name=s3_path["bucket_name"],  # type: ignore[index]
        bucket_key=s3_path["bucket_key"],  # type: ignore[index]
        deferrable=True,  # 是否交給 triggerer 執行,不佔用 worker slot
        poke_interval=30,  # 每次檢查間隔秒數,正式建議 >= 60
        timeout=3600,  # 逾時秒數
    )

    @task(task_id="fetch_object", retries=0)
    def fetch_object(bucket_name: str, bucket_key: str) -> int:
        content = S3Client(bucket_name=bucket_name).get_object(bucket_key)

        logger.info("[S3KeySensor] 在 S3 %s/%s 偵測到檔案", bucket_name, bucket_key)
        return len(content)

    @task(task_id="print_object_length", retries=0)
    def print_value(content_length: int) -> None:
        print(f"[S3KeySensor] 成功取得 {content_length} bytes")

    fetch_object_task = fetch_object(
        s3_path["bucket_name"],  # type: ignore[index]
        s3_path["bucket_key"],  # type: ignore[index]
    )

    wait_for_object.set_downstream(fetch_object_task)
    print_value(fetch_object_task)  # type: ignore[arg-type]

if __name__ == "__main__":
    dag.cli()
1. 取得 S3 路徑
正式流程中檔案上傳的路徑是由程式按照規則產生的
這邊為了方便測試,改成觸發時手動輸入 bucket_name/bucket_key
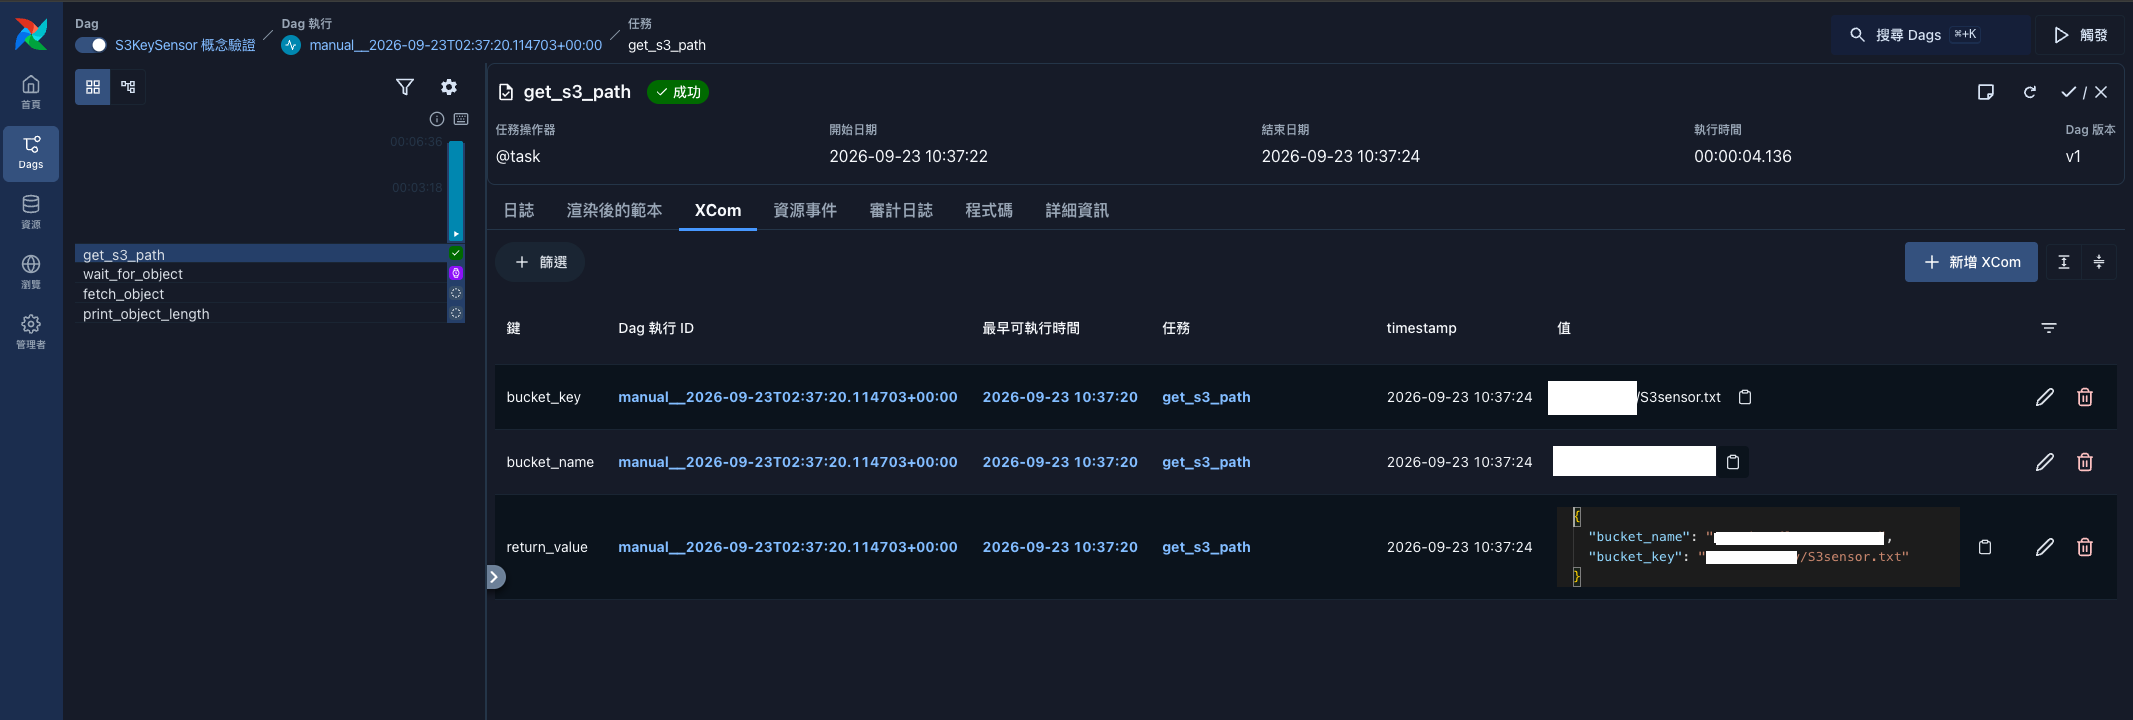
可以在 XCom 分頁看到 bucket_name、bucket_key 各自被記錄下來
而 return_value 則是包成 dict 一起傳出去
這裡的關鍵是 multiple_outputs=True
它讓 dict 裡的每個 key 各自存成獨立的 XCom,下游才能用 s3_path["bucket_name"] 直接取值
沒有設定的話 XCom 就只會存一份 return_value
這時候 s3_path["bucket_name"] 拿到的其實是 None,而不是預期中的字串
2. 用 S3KeySensor 等待 S3 object 出現
透過 deferrable sensor 等待 get_s3_path 傳來的路徑真的出現檔案
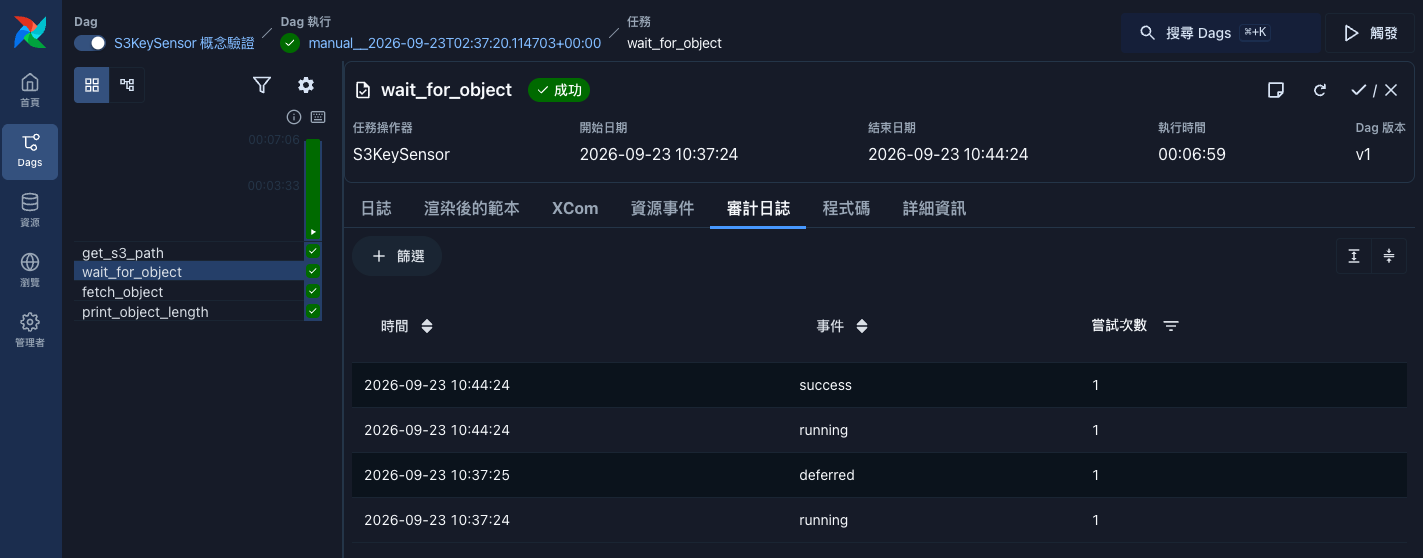
從審計日誌可以清楚看到狀態變化:running -> deferred -> running -> success
一開始 task 執行後馬上轉成 deferred 狀態
中間等了將近 7 分鐘,這段期間完全不佔用 worker
3. 偵測到檔案後讀取內容
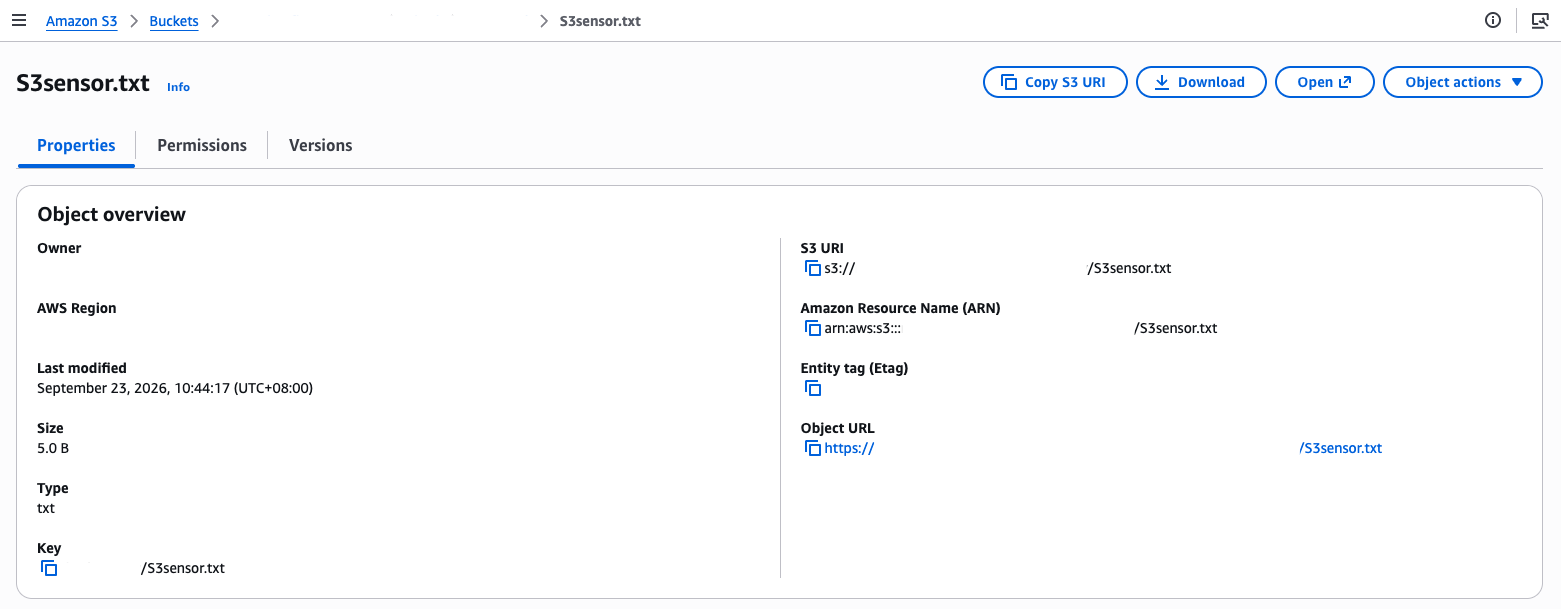
手動上傳檔案,模擬外部 API 生成檔案
當 S3KeySensor 偵測到檔案出現後就從 deferred 恢復並往下執行
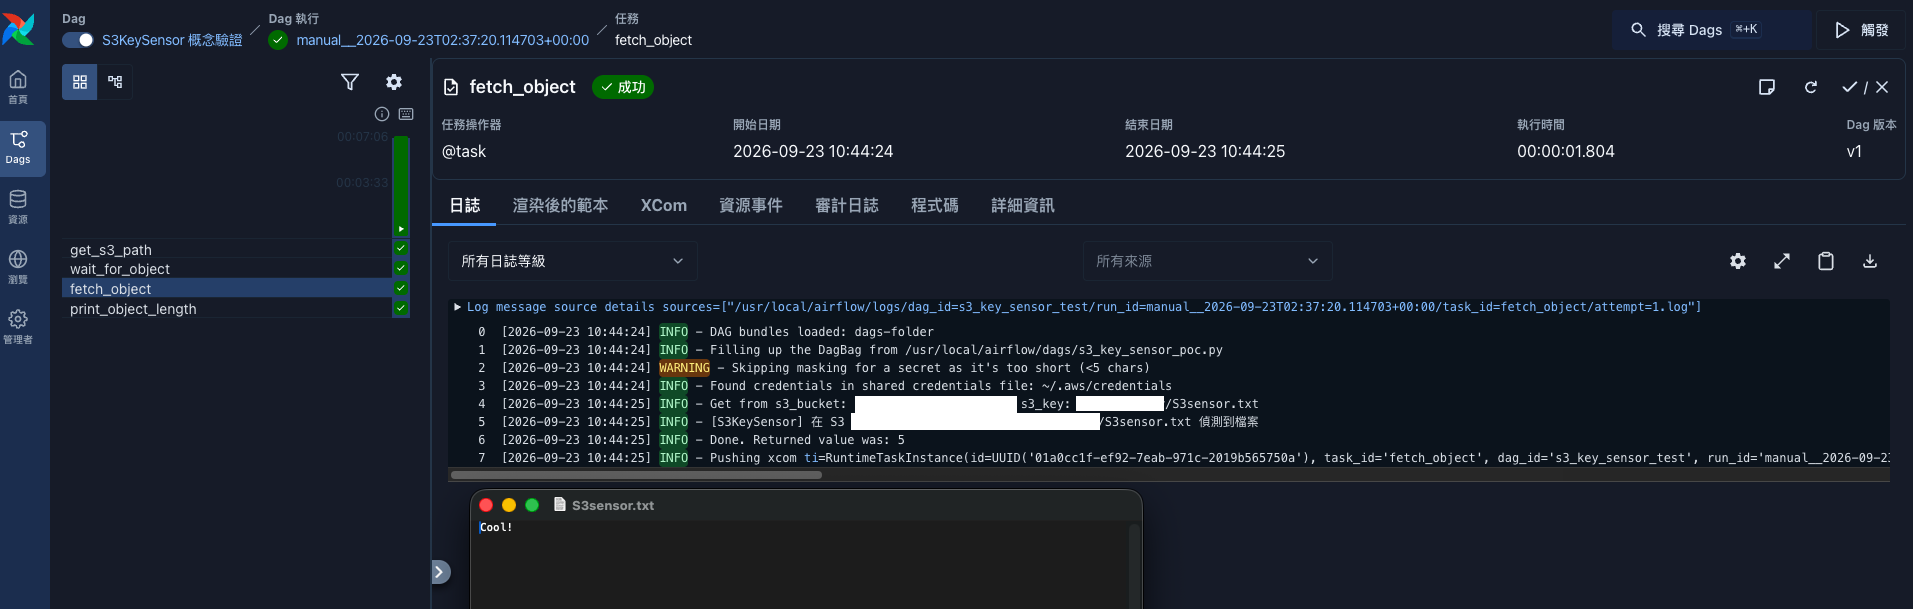
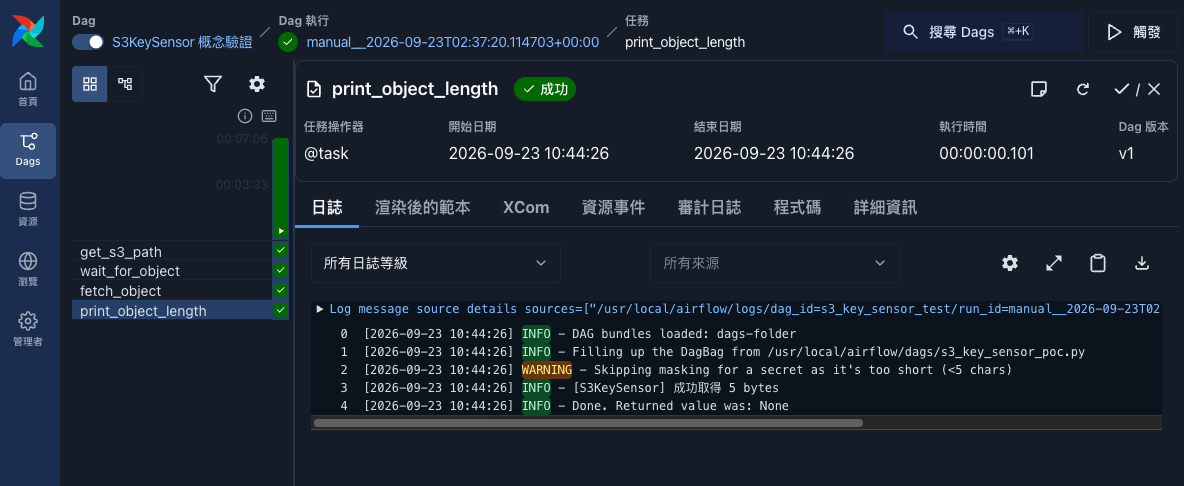
比對 log 和實際檔案內容長度一致
注意事項
使用 deferrable 模式需要環境有啟用 triggerer 元件,沒開的話 task 會卡在 deferred 永遠不會被喚醒
在 PoC 裡沒有另外設定 aws_conn_id,是直接吃 MWAA 執行角色的預設 boto3 憑證鏈
「worker 被回收就失敗」的問題不是 100% 消除,而是換成一個更輕量的依賴
During the deferred phase of execution, since work has been offloaded to the triggerer, the task no longer occupies a worker slot, and you have more free workload capacity.
等待邏輯改成跑在獨立的 triggerer process 上,所以變成依賴 triggerer 要活著
好消息是 deferred 狀態有存進 metadata DB,即使 triggerer process 重啟也不會直接判失敗,藉此達成高可用的目標
Airflow automatically re-schedules triggers that were on that host to run elsewhere.
當條件成立、trigger 觸發之後,也還是要交回一個 worker 才能真正執行完 task:
- The trigger runs until it fires, at which point its source task is re-scheduled by the scheduler.
- The scheduler queues the task to resume on a worker node.
所以說使用 deferrable 可以消除的是
- 等待期間依賴的 worker process 隨時可能被 ECS 回收
換成風險低很多的
-
依賴 triggerer 存活
- deferred 狀態的任務存在 metadata DB
- 就算其中一個 triggerer 掛掉 scheduler 也會自動把 trigger 轉給其他還活著的 triggerer
-
恢復執行時仍需要排到一個 worker
- 只在任務真正執行的時間內佔用 worker slot